プロフェッショナルデジタルスキル(データ・AI)試験を読み解く【シラバス編】― 既存の試験とは,ほとんど重ならない新しい試験
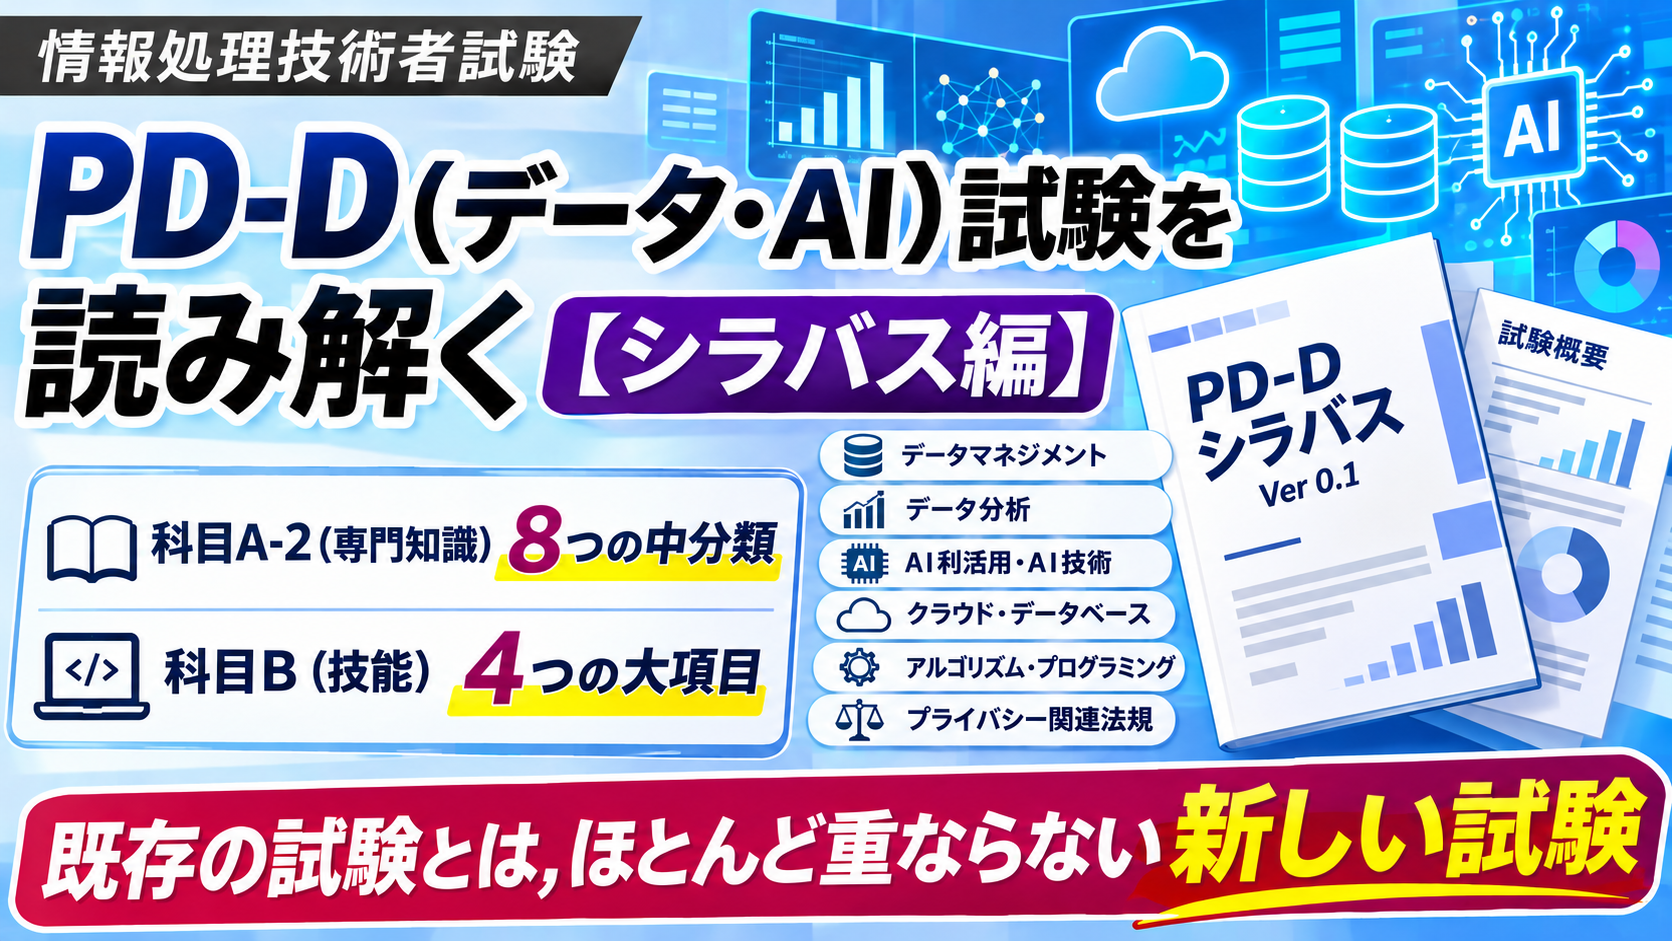
昨日お知らせしたプロフェッショナルデジタルスキル(データ・AI)試験(仮称,PD-D)のシラバス(案)Ver 0.1を,早速読み解いていきます。今回は,科目A-2(専門知識)の8つの中分類と,科目B(技能)の4つの大項目の中身を整理します。結論を先に言うと,PD-S・PD-Mが現行の高度試験を「再配置」した試験だったのに対して,PD-Dは既存の試験とはほとんど重ならない,本当に新しい試験です。
まず押さえる事実 ― PD-D試験とは何か
分析に入る前に,一次情報を整理しておきます。
- PD-Dの位置づけ:IPAの出題範囲改定案では,「組織やビジネスのデータドリブンな活動を支える基盤を構築してデータを整備する専門的な知識及び技能」を評価する試験とされています。
- 試験構成:科目A-1(共通知識,90分・60問)/科目A-2(専門知識,23問)+科目B(技能,12問)合わせて120分。PD-S・PD-Mと同じく全問必須解答・全問多肢選択式のCBT方式です。
- シラバス(案)Ver 0.1:PD-S・PD-MのVer 0.1は科目Bだけの先行公開でしたが,PD-Dは最初から科目A-2と科目Bの両方が収録されています(全28ページ)。
- 科目Bの出題割合:シラバスに「科目Bの各項目の出題割合は基本的に大項目の構成に基づきます」とあります。4つの大項目から12問なので,各大項目から3問前後ずつ出題されると見込まれます。
- 科目Bの注記:改定案に「データの操作について,SQLを扱う」「プログラム言語について,擬似言語を扱う」と明記されています。
出典:IPA「新試験制度のシラバス案について」で2026年10月30日に公開されたプロフェッショナルデジタルスキル(データ・AI)試験(仮称) シラバス(案)Ver 0.1(PDF),および「情報処理技術者試験・情報処理安全確保支援士試験 出題範囲等の改定案」を分析対象としています。いずれも(案)であり,今後変更される可能性があります。
科目A-2(専門知識)― 8つの中分類
科目A-2の出題範囲は,全区分共通の「7大分類・30中分類」の体系から,次の8つの中分類が選ばれています(昨日のお知らせ記事では「7中分類」と書きましたが,「AI利活用」を数え落としていました。正しくは8中分類です。お詫びして訂正します)。
| 大分類 | 中分類 | 主な用語例(シラバスより抜粋) | 既存の試験との関係 |
|---|---|---|---|
| 2 データ・AIの利活用 | 8 データマネジメント | データガバナンス,CDO・DMO・データスチュワード,データ品質(ISO 8000),メタデータ・データカタログ・データリネージ,データメッシュ,MDM(レジストリ型/コンソリデーション型 など),データスペース,データプロヴェナンス | DM試験と土台は共通。ただし深さが違う |
| 2 データ・AIの利活用 | 9 データ分析・データ利活用 | データレイク/DWH/レイクハウス,ETL/ELT,CDC,べき等性,バックフィル,セマンティックレイヤー,ベイズの定理,回帰分析,因果推論,p値,検出力,統計的バイアス,再現性の危機,可視化,線形計画法,QC七つ道具 | ほぼ新規(業務分析の一部はAP午前の経営工学) |
| 2 データ・AIの利活用 | 10 AI利活用 | 人間中心のAI社会原則,AI事業者ガイドライン,ISO/IEC 42001,識別AIの活用例,生成AI(Temperature・Top-p,RAG,Lost in the Middle,コンテキスト腐敗),AIエージェントの自律性のタイプ,ガードレール | 新規 |
| 4 デジタル技術 | 15 クラウド | 共有責任モデル,マルチAZ・マルチリージョン,RTO/RPO/RLO,FinOps,ストレージ階層化,クラウド移行(Rehost/Replatform/Refactor など),IaC,Kubernetes | PD-Sと共通の範囲 |
| 4 デジタル技術 | 17 データベース | 3層スキーマ,E-R図,正規化,SQL(ウィンドウ関数,相関副問合せ),MVCC,2相ロッキング,ライトスキュー,インデックス,障害回復,CAP定理,BASE特性,シャーディング,Hadoop/Spark,Hive/Presto | DB試験の午前Ⅱとの重なりが最も大きい |
| 4 デジタル技術 | 18 AI技術 | 決定木,アンサンブル学習,SVM,k-means,Q学習,交差検証,ROC曲線・AUC,CNN/RNN/LSTM/Transformer,GAN,拡散モデル,LLM,RLHF,蒸留・量子化,ReAct,CoT,Function Calling,MCP,A2A,マルチエージェント | 新規(G検定・E資格の領域) |
| 5 システムの開発・運用 | 22 アルゴリズム・プログラミング | 線形代数(固有値,逆行列),数値解析,計算量,データ構造,KMP法・BM法,ダイクストラ法,最大フロー問題,自然言語処理のアルゴリズム(形態素解析,n-gram),Python/R,CSV/JSON/YAML | FE・APのアルゴリズムの延長 |
| 7 倫理・コンプライアンス | 29 プライバシー関連法規 | 個人情報保護法,仮名加工情報・匿名加工情報,GDPR,越境移転,PIA,k-匿名化,差分プライバシー,連合学習 | 法規はSCなどと共通。技術的な保護手法は新規 |
表を眺めると,「AI利活用」と「AI技術」が別々の中分類として丸ごと入っていること,そして「データ分析・データ利活用」に統計学の用語が本格的に並んでいることが目を引きます。MCP(Model Context Protocol)やA2A(Agent2Agent Protocol),コンテキストエンジニアリングのような,2025年以降に広まった用語まで含まれており,これまでの情報処理技術者試験では問われたことのない用語がかなりの割合を占めます。
一方で,既存の試験に近いのは「データベース」と「アルゴリズム・プログラミング」で,ここはデータベーススペシャリスト(DB)試験や応用情報技術者(AP)試験の学習がそのまま活きます。ただし,その2つを足しても8中分類のうちの2つです。科目A-2は23問しかないので,1中分類あたり3問程度と考えると,専門知識の多くは新しい分野から出ることになります。
科目B(技能)― 4つの大項目
科目Bは,次の4つの大項目で構成されています。それぞれの小項目の数と,私なりに見た「母体となる既存の試験」,サンプル問題の対応を整理します。
| 大項目 | 小項目 | 母体となる既存の試験(筆者の見方) | サンプル問題 |
|---|---|---|---|
| 1 データマネジメントに関すること | 1-1〜1-9(9つ) | 新設のDM試験からの発展 | 問1(データコントラクト) |
| 2 データ・AIの活用に関すること | 2-1〜2-5(5つ) | 完全新規 | 問2(散布図行列・重回帰分析),問3(LLMの活用) |
| 3 データ基盤の構築に関すること | 3-1〜3-4(4つ) | DB試験の内容 + データ基盤(新規) | 問4(データレイク・DWH) |
| 4 データ処理とアルゴリズムに関すること | 4-1〜4-3(3つ) | AP科目B問3(プログラミング) + SQL | 問5(SQL・統計情報),問6(擬似言語によるデータ補正) |
なお,大項目3は,出題範囲改定案の段階では「データエンジニアリングに関すること」という名前でしたが,Ver 0.1のシラバスでは「データ基盤の構築に関すること」に改められています。中身の方向性は変わっていません。
SQLについては,大項目3ではなく,大項目4の「データ処理とアルゴリズムに関すること」で問われることになります。
大項目1:データマネジメント ― DM試験の「現場の技能」を,「設計する側」に引き上げたもの
大項目1は,小項目が9つあり,4つの大項目の中で飛び抜けて詳しく書かれています。シラバス自身も「本シラバスを活用する方々が内容を理解しやすいように詳細まで記載しています」と断っており,末尾には各小項目の概要と参考図まで補足されています。IPAがこの試験で最も丁寧に説明したかった部分だと言えます。
内容は,データ戦略・基本方針の策定支援(1-1),体制・役割・プロセスの設計(1-2),データアーキテクチャの設計(1-3),方針・規程・ルール・標準の策定と運用プロセスの設計(1-4),データの管理・取扱いの支援(1-5),データの整備・提供と意思決定の支援(1-6),普及・定着支援(1-7),新技術の調査・PoC(1-8),活動のモニタリング・評価(1-9)です。
DM試験のシラバスを読んだ記事で,DMの科目Bは「ルールを作る側ではなく,守り,活かす側」の技能だと書きました。PD-Dの大項目1は,まさにその裏返しです。補足には「経営層やCDOが担う組織としての方針・体制などの最終決定・承認は対象とせず,その検討や案の作成,専門的な設計及び実行・支援に必要な技能を問う」とあり,想定している役割はデータスチュワード,データアーキテクト,データエンジニアです。DM試験がビジネスパーソン向けの「使う側」なら,PD-Dは「仕組みを設計して組織に回す側」で,同じデータマネジメントでも,一段上の立場から問われることになります。
サンプル問題の問1は,分散型(各部門がオーナーシップをもつ)のデータマネジメントの下で,データコントラクトを使って提供者と利用者の責任を整理する問題でした。データメッシュ的な考え方が,初回のサンプルから正面に出ています。
大項目2:データ・AIの活用 ― 完全新規。データサイエンスとAI技術が「がっつり」出る
大項目2は,データ分析の目的設定と進め方の設計(2-1),BIツールなどによる集計・可視化・レポート(2-2),統計学・機械学習・時系列解析を用いた分析処理の実行(2-3),マルチモーダル・RAG・AIエージェントなどの生成AI技術の適用(2-4),AI倫理の考慮(2-5)の5つです。
技能の例を見ると,「仮説検定,相関分析,回帰分析などの統計的手法を用いて,データの差異や関係性を検証し,結果を解釈するスキル」「機械学習モデルを用いて,予測,分類などを行い,性能指標に基づいてモデルを評価し,改善するスキル」「時系列データに対して,トレンド,季節性,自己相関などを分析」「プロンプト,参照情報,ツール連携などを設計し,期待する出力が得られるように調整するスキル」と,これまでの情報処理技術者試験では一度も問われてこなかった,データサイエンスとAI技術の中身そのものが並びます。
ここは,既存のどの区分にも母体がありません。あえて近いものを挙げるなら,データサイエンティスト検定やG検定といった民間資格の領域です。それが国家試験の科目Bとして,ケース問題の形で出題されることになります。個人的には,ここが一番新しくて,一番楽しいところです。サンプル問題では,問2がECサイトの利益を題材にした散布図行列と重回帰分析のモデル評価・解釈,問3がLLMを使った保守支援システムで「追加学習か,検索して文脈に与えるか」を判断させる問題で,大項目2の雰囲気がよく出ています。
大項目3:データ基盤の構築 ― DBスペシャリストの中身が,ここに残っている
大項目3は,業務の理解に基づく管理対象データの明確化(3-1),概念・論理・物理の各データモデルの作成(3-2),一貫性・整合性を確保したデータ統合・変換(3-3),データ基盤・データパイプラインの設計・構築・運用(3-4)の4つです。
3-1から3-3の技能の例を見ると,「管理対象データの定義域及び関係を明確化」「整合性制約及び振舞いを明確化」「意味,完全性,安定性を考慮して妥当な概念データモデルを設計・検証」「正規化した論理データモデル」「性能・拡張性,可用性,運用性を考慮して妥当な物理データモデル」「分離レベルの選択,排他制御の最適化,デッドロック抑制」「非正規化とインデックス選定による性能調整」「RTO/RPOに基づいて,バックアップ方式・回復手順・世代管理・復旧テストを設計・運用」と,現行のデータベーススペシャリスト試験の午後問題で問われてきた内容が,ほぼそのまま残っています。DB試験の学習をしてきた方にとっては,ここが一番の拠り所になります。
ただし,3-4は新しい内容です。データレイク・DWHなどへの集約や分散型のデータ基盤の構築,ストリーミングとバッチの設計,データリネージを考慮した自動化されたデータパイプライン,データカタログの更新といった,いわゆるデータエンジニアリングの領域で,これはDB試験では問われてきませんでした。サンプル問題の問4(データレイク・DWH・データマートの役割とデータの加工・保存)は,こちらの3-4に当たります。
大項目4:データ処理とアルゴリズム ― AP科目B問3の「プログラミング」に近い
大項目4は,SQLによるデータのCRUD操作(4-1),データ構造とプログラミング(4-2),アルゴリズムとプログラミング(4-3)の3つです。改定案の注記どおり,プログラムは擬似言語で出題されます。
PD-Dらしいのは4-1で,DDL・DMLに加えて「集約関数,Window関数,統計関数,再帰構文などを使用して高度な計算を行うSQL文を記述し,実行するスキル」が明記されています。SQLが「データ処理の道具」として,アルゴリズムと並べて置かれているのがこの試験の特徴です。
4-2・4-3の技能の例は,「データ構造を操作するプログラムを読み解き,データがどのように変化するかを正しく把握する」「アルゴリズムを実装したプログラムから,非効率な箇所や動作不良の原因となる箇所を見出し,適切に改修する」「テストプログラムを設計する」といったもので,応用情報技術者試験の科目B問3(プログラミング)や,基本情報技術者試験の科目Bのアルゴリズム問題に近い内容です。サンプル問題の問6も,得点の配列を中央値で補正する擬似言語プログラムを読み解く問題で,AP問3と同じ感覚で解けるものでした。
そして問5は,不動産の物件情報検索システムを題材に,RDBMSの統計情報(行数・列値個数)から各SQL文の結果行数を見積もり,WITH句とCOUNT・GROUP BYを使った集計SQLを完成させる問題です。SQLを扱う4-1に当たります。この題材には見覚えがあり,令和3年度 秋期 データベーススペシャリスト試験 午後Ⅰ 問3「テーブルの移行及びSQLの設計」(問題PDF/解答例PDF)が流用元と思われます。不動産賃貸仲介業のA社,20個の設備の有無を記録する“物件”テーブル,行数1,600,000・沿線の列値個数400という統計情報まで同じで,元の問題では物件設備のデータ構造変更に伴う移行SQLと互換ビューの設計を問うていました。PD-Dでは,そのうち「統計情報から結果行数を見積もり,集計SQLを完成させる」部分が多肢選択式の1問として切り出されています。従来のDB試験の資産が,形を変えてPD-Dに使われていることがよく分かる例です。
「既存の試験があまり関わってこない」ことの意味
4つの大項目を既存の試験と対応させると,次のようになります。
| 大項目 | 既存の試験との重なり |
|---|---|
| 1 データマネジメント | 新設のDM試験と土台は共通だが,「設計する側」として一段上。現行の区分には母体なし |
| 2 データ・AIの活用 | 母体なし(完全新規) |
| 3 データ基盤の構築 | DB試験の午後の内容(データモデリング・トランザクション・性能・回復)が残る。データ基盤は新規 |
| 4 データ処理とアルゴリズム | AP科目B問3・FE科目Bのアルゴリズムに近い。SQLはAP科目B問6やDB科目B試験の内容に近い。 |
PD-Sは「NW・ES・SAの再配置」,PD-Mは「ST・PM・SM・AUをほぼ素直に統合」と,これまでの記事で分析してきました。それに対してPD-Dは,現行の高度試験で母体と呼べるのはDB試験だけで,しかもそれは4つの大項目のうちの1つの,さらに一部です。出題割合が大項目の構成に基づくなら,12問のうちDB由来と言えるのは2〜3問程度で,残りはデータマネジメント,データサイエンス,AI,データエンジニアリングといった新しい領域から出ることになります。
これは,DB試験の合格者にとっては「蓄積が活きる場面が思ったより少ない」ということでもあり,逆に,データ分析やAIを仕事にしていてDB試験には縁がなかった方にとっては,「自分の得意分野が,初めて国家試験の正面に据えられた」ということでもあります。筆者は後者の意味で,この試験にとても期待しています。
学習の方向性(現時点での見立て)
詳しい学習法は今後の記事に譲りますが,シラバスから見える方向性だけ挙げておきます。
- DB試験の学習経験がある方:大項目3(データモデリング・トランザクション・性能)と大項目4(SQL)は強みです。そこを土台に,大項目1・2の新しい領域を積み上げる形になります。
- データ分析・AIが本業の方:大項目2は得意分野のはずです。一方で,大項目3・4のデータモデリング・SQL・アルゴリズムと,大項目1のデータマネジメントは,体系的に学ぶ機会が少なかったかもしれません。ここをDB試験の過去問題やAP科目B問3で補うのが近道です。
- 共通して必要なこと:科目A-2の8中分類は,用語例のレベルで新しいものが非常に多いので,シラバスの用語例には一度,全部目を通すことをお勧めします。統計学は,仮説検定・回帰分析・ベイズの定理あたりまでは基礎として要求されます。
まとめ
- PD-Dの科目A-2は8中分類。「AI利活用」と「AI技術」が丸ごと入り,データベースとアルゴリズム以外は新しい用語が大半です。
- 科目Bは4大項目。大項目1はDM試験の発展(設計する側),大項目2は完全新規のデータサイエンス・AI,大項目3にDB試験の内容が残り,大項目4はAP科目B問3に近いプログラミングです。
- PD-S・PD-Mが現行区分の再配置だったのに対して,PD-Dは既存の試験とほとんど重ならない,本当に新しい試験です。
- わく☆すたとしては,この試験に一番力を入れていきます。次回以降,科目Bサンプル問題6問の詳しい分析や,試験勉強に合わせて新しい内容を学習する方法を記事にしていく予定です。
▶ 関連記事:PD-D 科目Bサンプル問題を読む/PD-D シラバス案・科目Bサンプル問題公開のお知らせ/DMシラバス案を読む/PD-S(システム)を読み解く【前編】/PD-M(マネジメント)を読み解く【前編】/共通科目A-1のシラバス案を読む/2027年度新試験の全体まとめ ▶ 区分ページ:PD-D(データ・AI)/PD試験/DM/新試験制度 情報まとめ